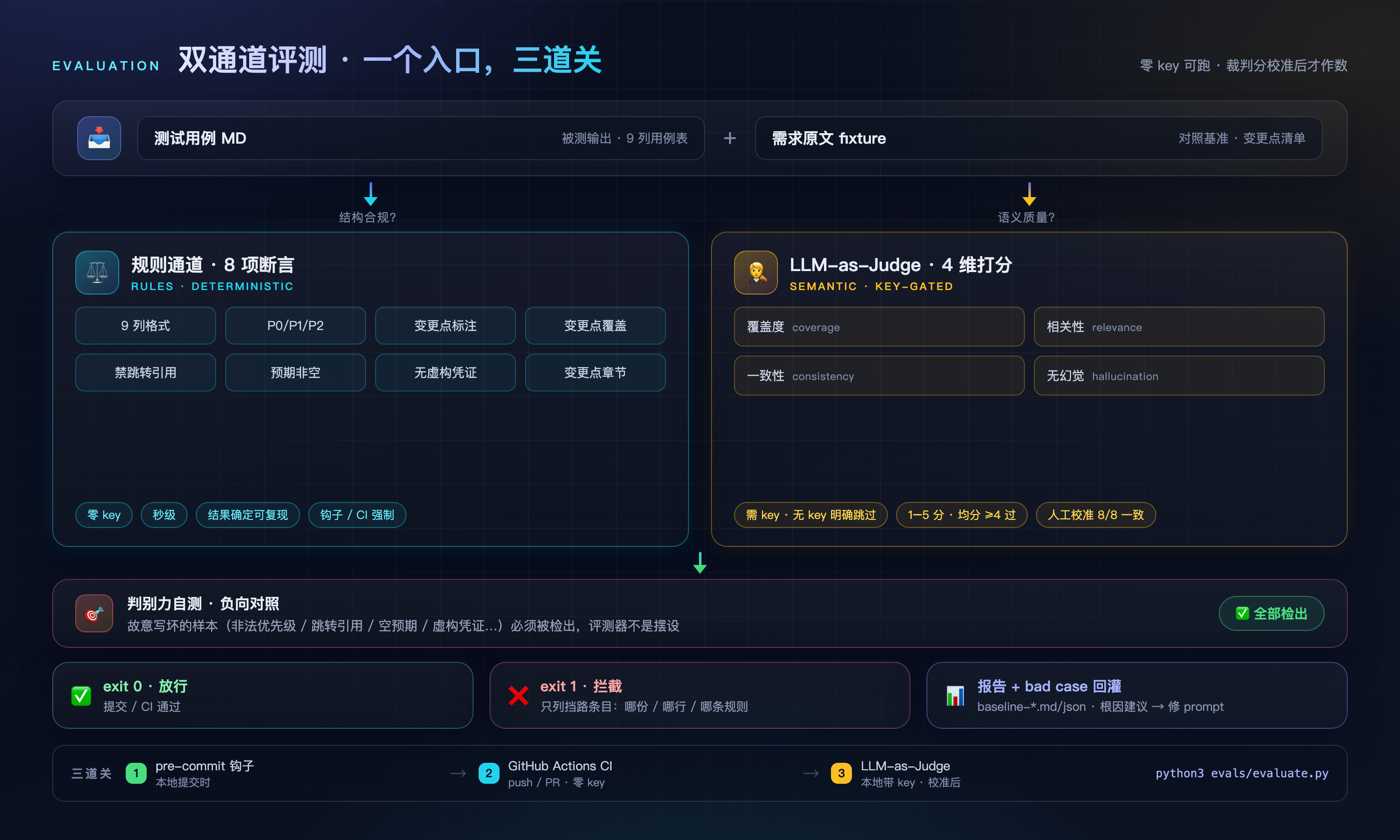
11 个 Agent Skill 覆盖 原型图理解 → 用例生成 → 一致性核查 → UI 自动化 → 验收报告; 核心是一台 零 key 可跑的测试用例评测器:8 条规则断言 + 4 维 AI 裁判 + 3 道质量门禁, 用 9 份故意写坏的用例证明自己没有放水,用 4 批校准记录证明分数可以追溯。
市面上多数工具在比「AI 能不能写用例」,这个项目在回答「你怎么知道它写得好」。 前者是一次演示,后者是一条可以回归、可以交接、可以量化改进口径的流水线。
AI 能在 30 秒里生成一份格式漂亮的用例,也能在同样的 30 秒里编出不存在的前置条件、漏掉一半变更点、写出跳转引用。 没有评测,这些错误只能靠人逐条读——于是「AI 提效」在评审环节又被还了回去。
编造的账号、密码、内网地址混在格式完美的表格里;人眼第一遍几乎看不出来,上线后才暴露。
换了 prompt、改了模型、调了规则,生成质量是变好还是变坏?没有基准集和 diff,只能靠感觉。
「这份用例不错」是个人判断。没有可执行的验收标准,换一个人、换一个模型,结论就变了。
列结构、优先级枚举、追溯引用、跳转引用、预期结果非空、凭证泄漏、变更点章节、变更点覆盖——8 条断言,零 key、毫秒级、结果可复现。
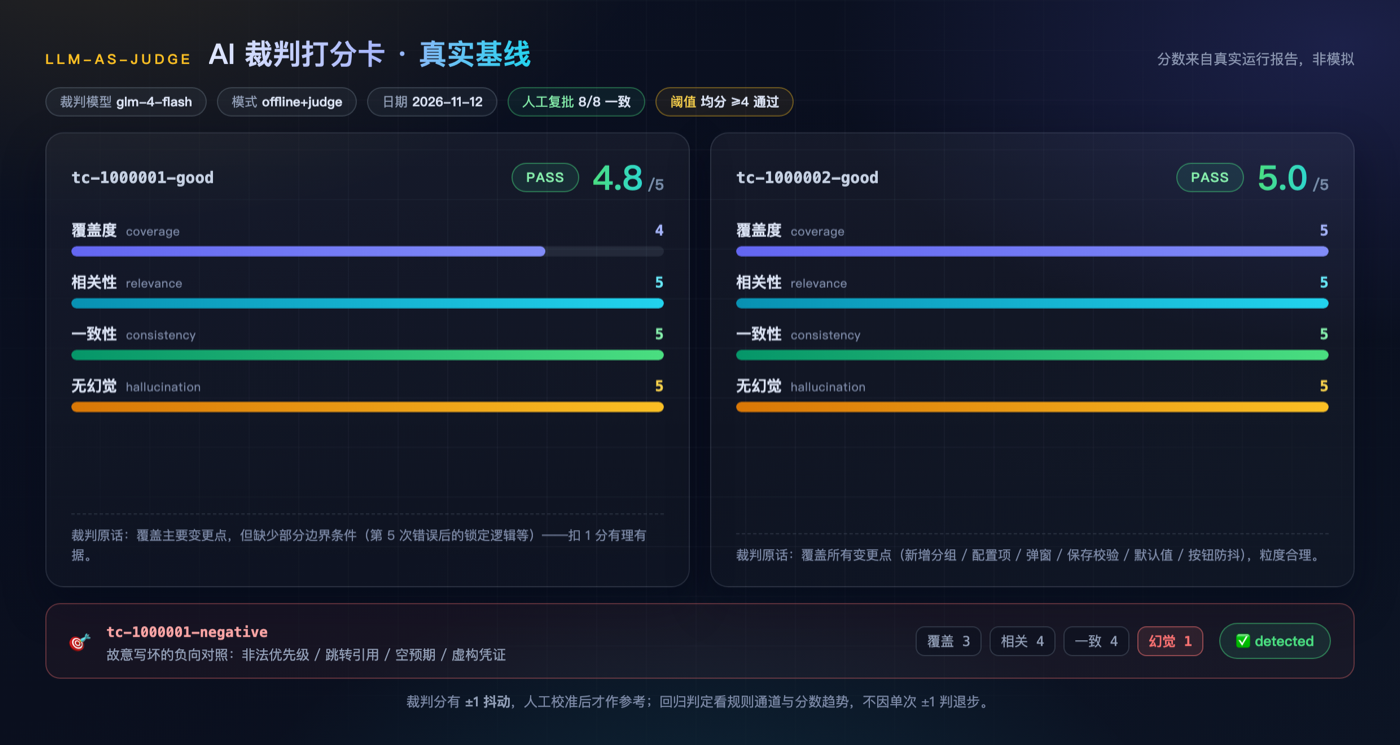
规则判不了的四个维度交给 LLM 裁判:覆盖度、相关性、一致性、幻觉。分数有上限映射、理由要能对上事实。
裁判与规则的矛盾率、裁判自身跑 3 轮的稳定性、裁判与人工的一致率——三层体检,缺一层都不能说「裁判可信」。
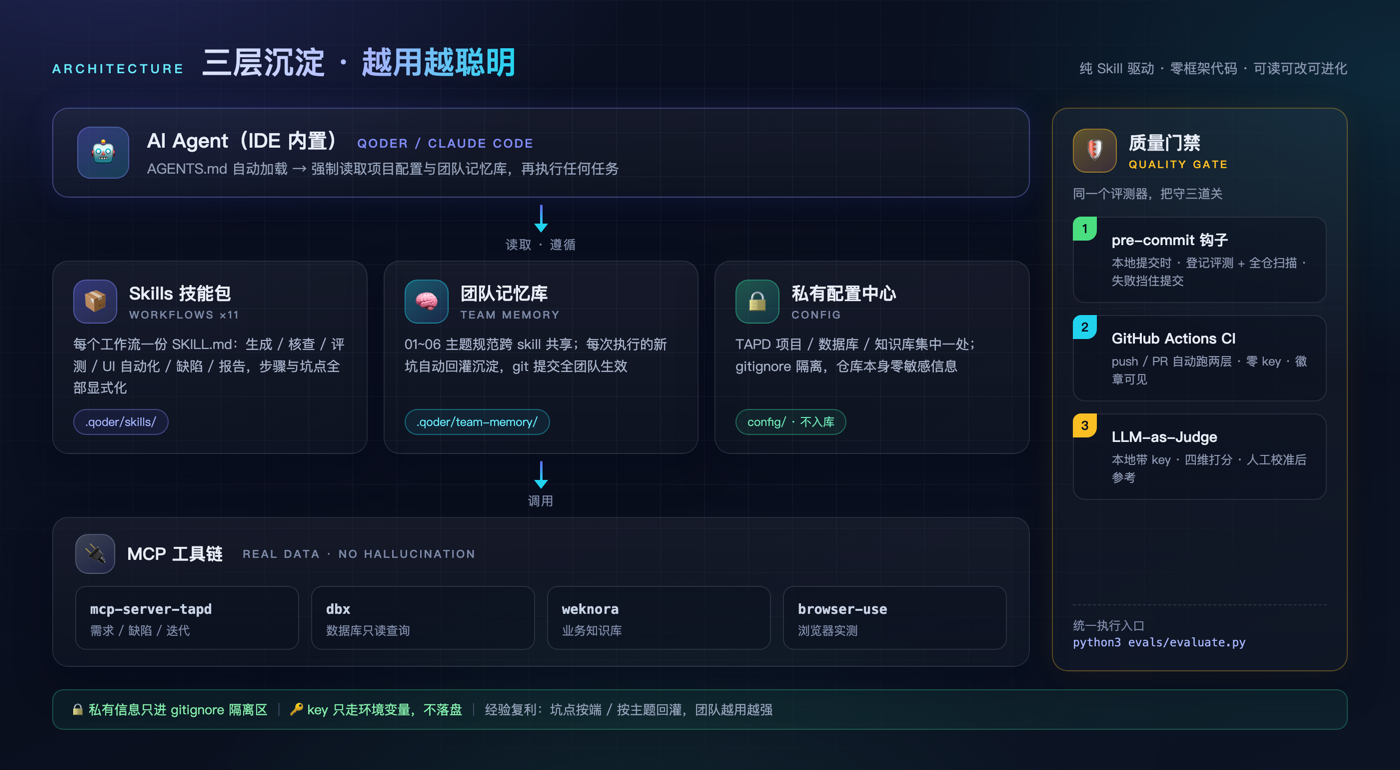
每个工作流一个 SKILL.md:步骤、坑点、口径全部显式化,AI 严格照此执行;跨 skill 的规范沉淀在 team-memory,私有配置集中在 gitignore 隔离的 config/。
这是整个项目的地基,也是最容易被做错的地方——很多「LLM 评测」让裁判从头判到尾,等于用一个不可靠的模型去评价另一个不可靠的模型。这里的顺序是:先由确定性规则把事实钉死,再让裁判只做语义判断,并且不允许它越权。
下面每个数字都能在仓库里找到对应报告:矛盾率来自 --judge-agreement 对存档报告的离线重算,稳定性来自 --runs 3 的 36 次真实裁判调用,校准记录在 calibration.yaml。
| 评测集版本 | 裁判-规则矛盾率 | 这一轮发生了什么 |
|---|---|---|
| v4 | 36% / 54%(A / B) | 裁判对格式与覆盖退化几乎无感:B 变体覆盖 0/5 仍给四维全 5.0 |
| v5 | 7% / 4% | 注入变更点清单与规则结论;剩余矛盾集中在「虚构凭证却给 5 分」 |
| v6 | 7% | hallucination 绑定 no_secrets 上限;那条治好了,又冒出「格式问题不算不一致」 |
| v7 | 0%(0/14) | 明禁两种逃逸措辞,矛盾率首次归零,正样本未被虚降 |
| v8 | 0% → 7% → 14% | 把例外改成判定动作 + 注入机械事实:反向可疑归零,但上限遵守退化(bc-0012) |
score = min(score, cap) 硬截断,而不是再往 prompt 里加一段话。
每条必须写清:现象、根因分类(prompt / model / tool / evalset / evaluator)、修法、验收标准、实测证据;根因与「已修复」需要人工签字,AI 起草不算数。
严格级(理由也必须站得住)分别是:cal-0003 为 8/14、cal-0004 为 146/212。四批口径不同,不合并成一个「人工一致率」——代批不是人工阅读。
这些不是「功能列表」,而是防止评测器变成橡皮图章的具体机制——每一条都有对应的测试或真实报告锚点。
9 份坏用例里 8 份只坏一处,每条规则各有一发「单规则隔离弹」;漏检任意一条,自测直接红。
按上限映射交叉核对裁判四维分数与规则结论,输出矛盾率与逐条明细;裁判未跑不进分母,不画 0%。
同一份产出评 3 轮:pass@3、各维极差、结论翻转清单。单轮失败如实记,不补分;不稳定维度交人工。
两份报告逐用例逐规则比较变好/变坏;负向对照的裁判分数变化只进「说明」,不污染真正的退步计数。
193 条 pytest 锁住规则边界、YAML 解析、扫描逻辑、真实报告锚点;改口径必须同时改测试。
badcase 标 fixed、校准写一致率,都必须有人签字;AI 只能起草。哪批是人工、哪批是代批,字段里写清楚。
把边界写清楚,比把亮点写大更有用——尤其是当评委问「你怎么知道你测得准」的时候。
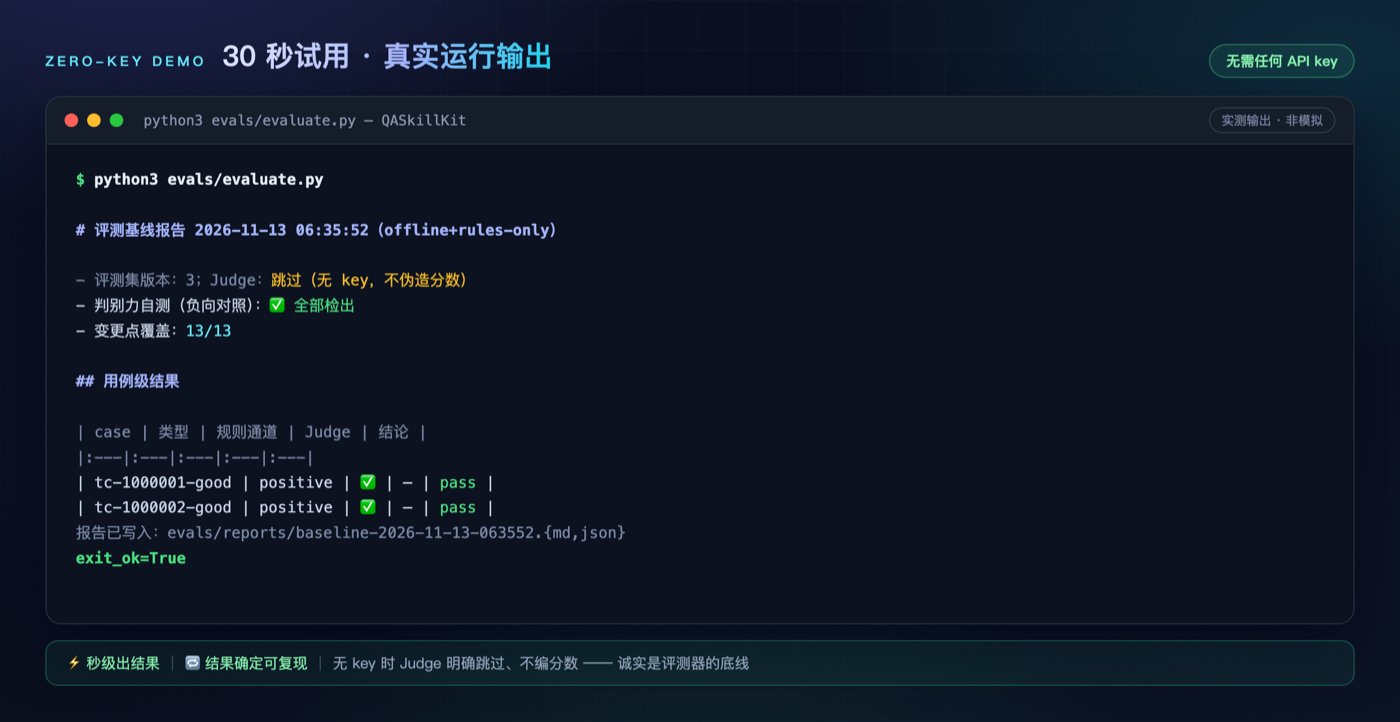
score = min(score, cap) 硬截断,等下一次带 key 实测。轨道 A 只需要 Python:克隆仓库、装 pyyaml、跑评测器。想看 AI 现场生成现场评,再加一个模型 key 跑 --live。
# 轨道 A:零 key 试用例评测 git clone https://github.com/WL2O2O/QASkillKit.git cd QASkillKit pip install pyyaml python3 evals/evaluate.py # 你会看到:3 份好用例 pass,9 份负向对照全部 detected # 报告写入 evals/reports/ # 想让 AI 当场写、当场评: export GLM_API_KEY=你的key python3 evals/evaluate.py --live
只要 Python 3 + pyyaml;无 TAPD、无 key、无 IDE。适合第一次接触的人先看判别力。
Qoder(或兼容 AGENTS.md 的 IDE)+ TAPD MCP + 可选 dbx / browser-use / 知识库;跑 /setup 生成私有配置后直接用。
pre-commit 钩子 + GitHub Actions 模板已就位;规则通道零 key,可以在每次 PR 上跑,不产生模型费用。
仓库:github.com/WL2O2O/QASkillKit · MIT License · 全部私有配置 gitignore 隔离,仓库零敏感信息。
四个常见追问的短答,细节都能在仓库里找到对应文件。
/setup 走一遍即可,私有信息只落在 gitignore 隔离的配置里。